Empresas de IA estariam comprando milhões de livros para treinar modelos, aponta reportagem
Empresas de inteligência artificial estariam adquirindo milhões de livros para alimentar seus modelos de linguagem, segundo reportagem da 404 Media. Parte das obras seria destruída durante o processo de digitalização, reacendendo o debate sobre direitos autorais e uso de conteúdo para treinamento de IA.
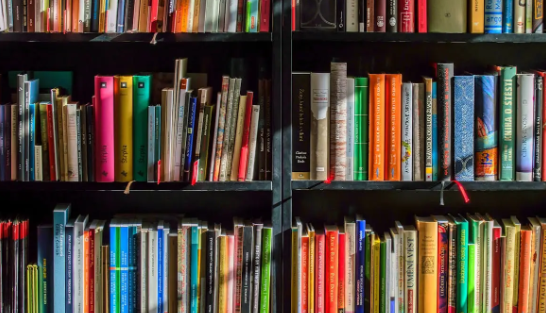
Empresas de inteligência artificial podem estar adquirindo milhões de livros físicos para ampliar a base de treinamento de seus modelos de linguagem. A informação foi divulgada pela 404 Media, publicação especializada em tecnologia, que aponta um aumento incomum nas compras em larga escala e indícios de que parte dessas obras estaria sendo destruída durante o processo de digitalização.
A prática surge em meio à busca das desenvolvedoras por conteúdos produzidos antes da popularização da IA generativa, considerados mais confiáveis para treinar novos modelos.
Busca por dados de maior qualidade
Segundo a reportagem, as empresas tentam evitar o chamado \AI slop\, expressão utilizada para descrever conteúdos de baixa qualidade gerados por inteligência artificial.
Como esses materiais podem comprometer o desempenho dos modelos, as desenvolvedoras passaram a priorizar obras produzidas antes de 2022, período anterior ao lançamento do ChatGPT e à explosão da IA generativa.
Livros publicados por autores humanos tornaram-se, assim, uma fonte valiosa de informação para alimentar sistemas de inteligência artificial.
Compras em escala chamam atenção
A investigação relata o depoimento de um livreiro profissional que afirmou ter registrado um salto expressivo nas vendas desde abril deste ano.
Segundo ele, o volume semanal passou de poucas dezenas para centenas de exemplares, enquanto plataformas especializadas passaram a registrar pedidos que variam entre 1.000 e até 1 milhão de livros em uma única operação.
Outro fator que chamou atenção foi a diversidade dos títulos adquiridos, sem concentração por autor, tema ou gênero literário, mas sempre envolvendo obras identificadas por ISBN.
ISBNdb também oferece acesso a bases de dados
A reportagem destaca ainda a atuação da plataforma ISBNdb, uma das maiores bases de dados bibliográficos do mundo.
Além de conectar livreiros, editoras e distribuidores, a empresa passou a oferecer serviços voltados ao mercado de inteligência artificial, incluindo acesso a bancos de dados que podem ser utilizados para o treinamento e ajuste fino de modelos de linguagem.
Embora não existam evidências públicas ligando diretamente empresas de IA às compras mencionadas, o perfil das transações levantou suspeitas entre profissionais do setor.
Digitalização pode destruir exemplares
Outro ponto abordado pela investigação é o processo de digitalização dos livros.
Segundo a 404 Media, empresas contratadas para converter as obras em arquivos digitais utilizam dois métodos principais.
O primeiro preserva a integridade física dos livros. Já o segundo, considerado mais rápido e econômico, exige que as páginas sejam destacadas para alimentação de escâneres industriais de alta velocidade, tornando impossível a reutilização dos exemplares físicos.
A publicação afirma que esse procedimento seria o mais utilizado pelas desenvolvedoras de inteligência artificial devido à sua eficiência operacional.
Debate sobre direitos autorais continua
O uso de livros para treinamento de modelos de IA já vem sendo alvo de disputas judiciais.
Empresas como Google e Anthropic enfrentaram processos relacionados ao uso de obras protegidas por direitos autorais.
Em um dos casos mais recentes, a Anthropic foi condenada ao pagamento de uma multa de US$ 1,5 bilhão por manter milhões de livros pirateados em seu banco de dados. Apesar disso, a decisão também reconheceu que, em determinadas circunstâncias, o treinamento de modelos de inteligência artificial pode se enquadrar na doutrina de uso justo (fair use) prevista na legislação dos Estados Unidos.
A nova reportagem reacende o debate sobre os limites legais e éticos do uso de obras intelectuais para o desenvolvimento da inteligência artificial, tema que continua dividindo empresas de tecnologia, autores, editoras e reguladores ao redor do mundo.
Comentários 0

Most Read




Deixe um Comentário